Un motore SQL colonnare e vettoriale, eseguito in un servizio di calcolo dedicato e isolato, che si integra nelle pipeline di Irion EDM® Application senza richiedere ambienti di sviluppo separati e raggiunge i dati dove si trovano.
Uno sguardo all’architettura dell’Analytics Engine: come elabora grandi volumi, come gestisce la memoria, come scala e come collabora con gli altri strumenti di elaborazione.
Perché un motore specializzato
I workload analitici hanno una forma propria. Il motore relazionale di Irion EDM gestisce con buone prestazioni elaborazioni su volumi importanti, anche con molti utenti che accedono contemporaneamente agli stessi dati, garantendo consistenza e gestione della concorrenza. Le elaborazioni analitiche su volumi ancora maggiori seguono tipicamente un modello diverso: leggono poche colonne su un numero molto elevato di righe, aggregano, confrontano finestre temporali, combinano sorgenti diverse.
Sono esigenze strutturalmente differenti, e quando condividono le stesse risorse la crescita dell’una può condizionare la stabilità dell’altra. Non per un limite del motore relazionale, ma perché i due tipi di elaborazione chiedono cose diverse all’infrastruttura.
L’Analytics Engine nasce da questa constatazione. È un motore SQL colonnare e vettoriale, integrato in Irion EDM Application, che affianca il motore tradizionale basato su SQL Server e permette di assegnare ogni elaborazione al motore più appropriato. Il dato resta nel sistema più adatto a conservarlo e governarlo; il calcolo viene eseguito dove è più efficace. Calcolo e persistenza possono così evolvere con criteri indipendenti, restando coordinati all’interno di pipeline governate.
Per chi lo usa, il paradigma resta familiare: l’Analytics Engine si usa come il Query Engine. Ciò che cambia è il modo in cui l’elaborazione avviene sotto il cofano.
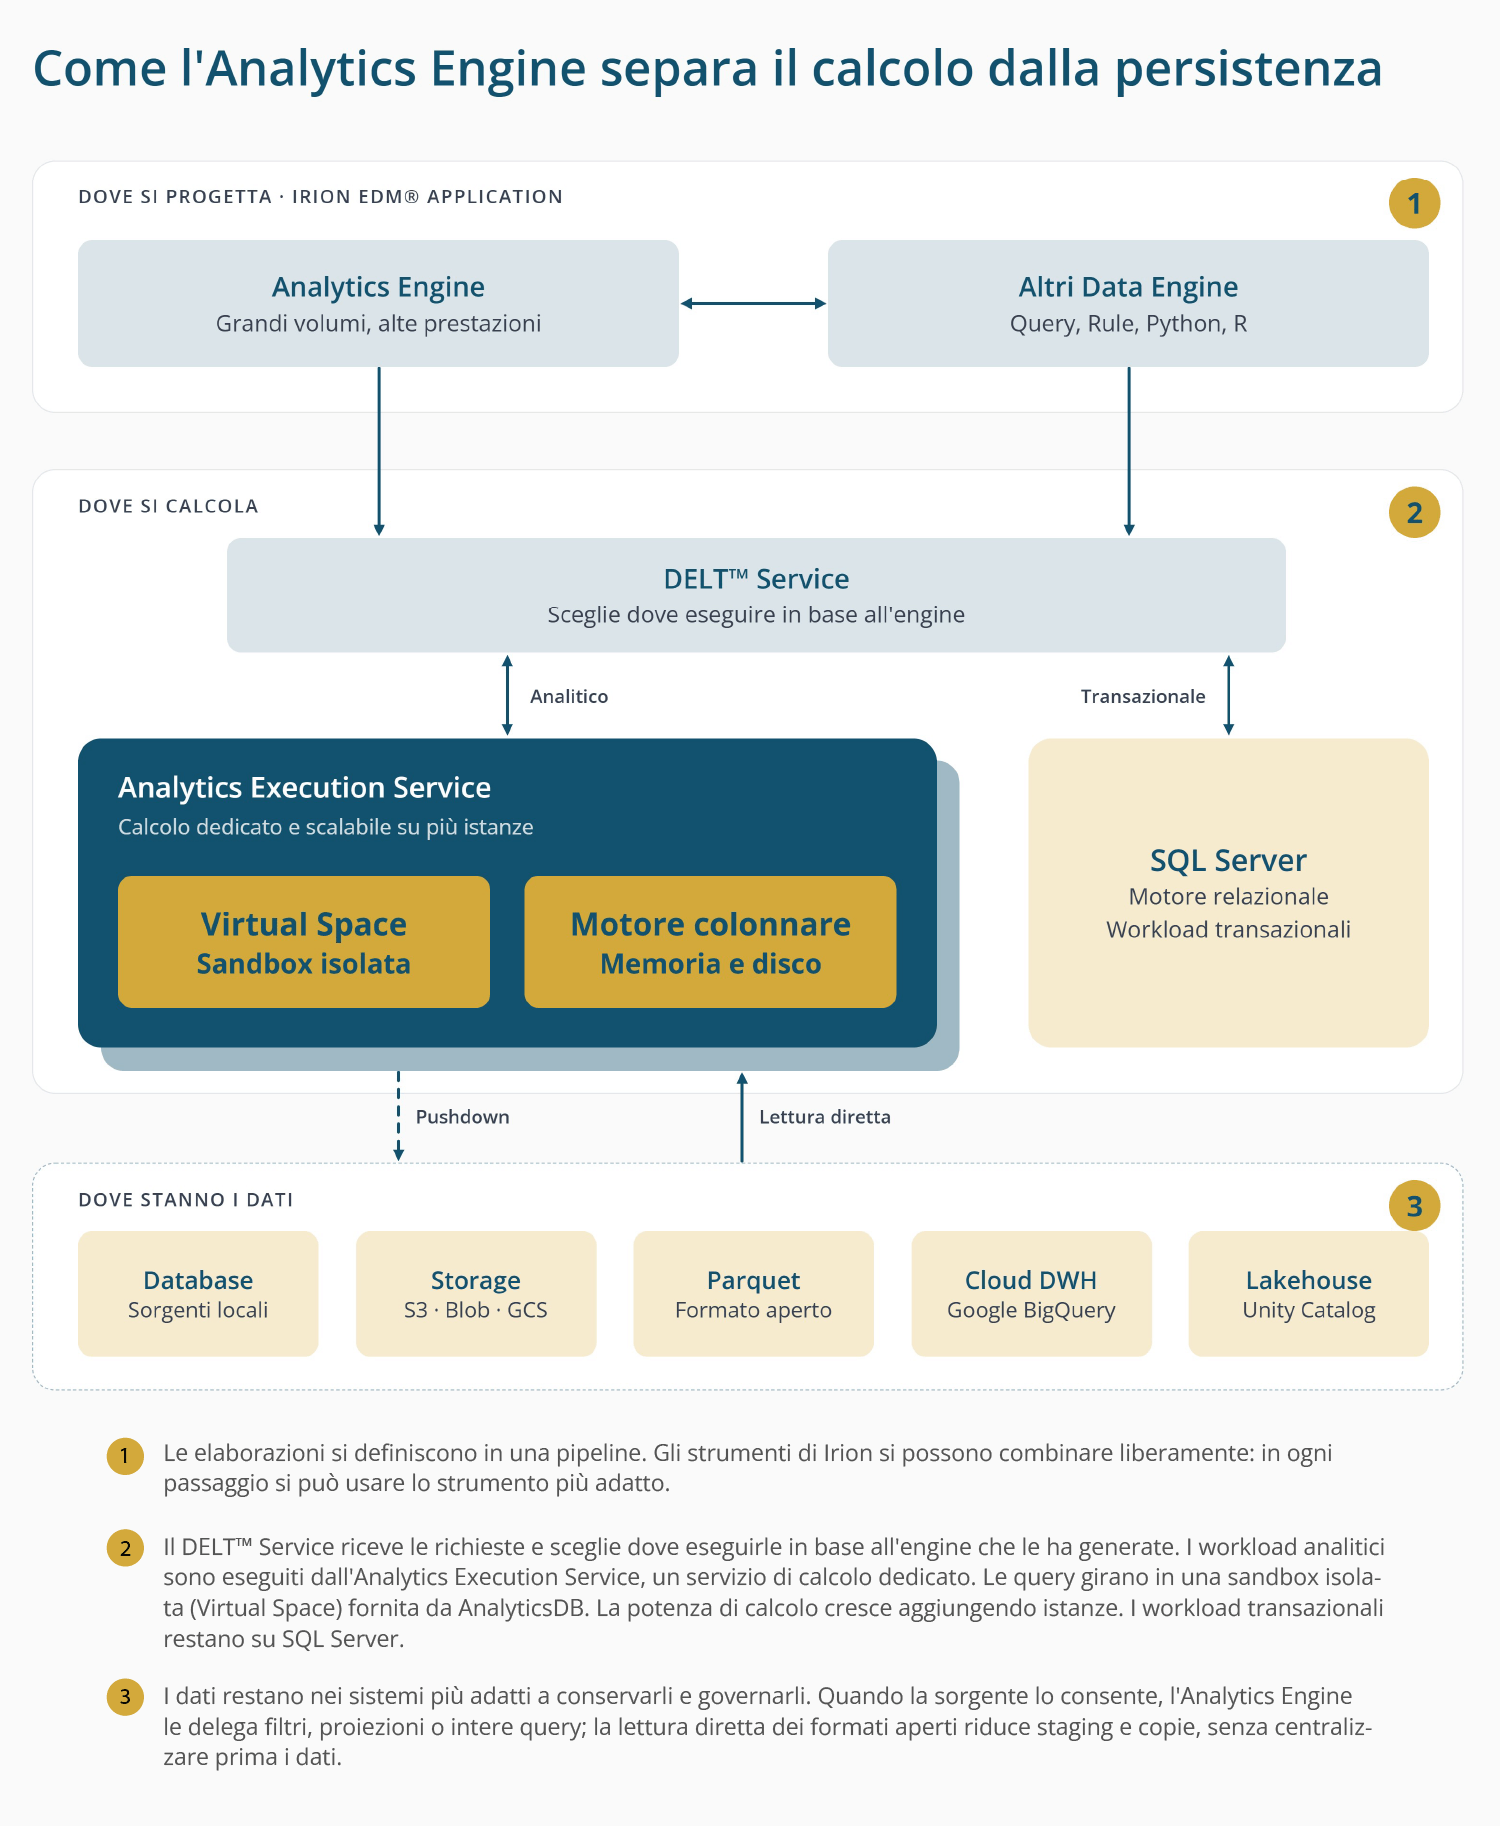
Lo schema che segue mostra come si distribuiscono i ruoli: dove si progettano le elaborazioni, dove vengono eseguite e dove risiedono i dati.
Leggere per colonne, calcolare per vettori
Il primo elemento dell’architettura è il modello di esecuzione. In un modello per righe, adatto alle operazioni transazionali, una query legge i record interi anche quando ne servono solo pochi campi. L’Analytics Engine elabora invece i dati per blocchi colonnari: legge soltanto le colonne necessarie alla query, non l’intero record.
Su questo si innesta l’esecuzione vettoriale. Le operazioni non vengono applicate valore per valore, ma su vettori di valori: somme, medie, raggruppamenti, finestre temporali e pivot sono trattati per blocchi. Il modello è coerente con la forma tipica delle elaborazioni su grandi dataset, in cui poche colonne vengono lette su moltissime righe.
L’effetto pratico è semplice da enunciare: meno lavoro inutile per produrre più risultato utile. È nelle elaborazioni ad alta intensità (aggregazioni su decine di milioni di record, scostamenti temporali, pivot, simulazioni su serie storiche) che questa architettura esprime il suo potenziale, ampliando il perimetro dei workload gestibili nei tempi del lavoro operativo.
Un uso virtuoso delle risorse
Il secondo elemento riguarda la gestione delle risorse. L’Analytics Engine sfrutta la memoria per accelerare l’elaborazione, ma non dipende esclusivamente da essa: quando il dataset supera la RAM disponibile, il motore prosegue utilizzando il disco, con uno spill automatico che non interrompe l’esecuzione.
La conseguenza è soprattutto architetturale. Il motore si adatta alla dimensione del workload: usa la memoria quando è disponibile e ricorre al disco quando serve. Non è quindi necessario dimensionare l’infrastruttura sui casi limite per garantire che le elaborazioni più pesanti arrivino a termine.
Un servizio di calcolo dedicato
L’Analytics Engine non condivide le risorse con il resto dell’applicazione. Le elaborazioni vengono eseguite da un servizio di calcolo dedicato, separato dagli altri servizi dell’applicazione: l’Analytics Execution Service (AES).
Nel lessico di settore si tratta di un’esecuzione out-of-process. Un’aggregazione su decine di milioni di record resta confinata nel perimetro del servizio, mentre il resto del sistema continua a funzionare senza impatti. L’isolamento preserva la reattività e la continuità degli altri servizi applicativi, anche quando il motore analitico lavora a pieno regime.
Lo stesso disegno rende la potenza di calcolo scalabile in modo indipendente. Non esiste un server centrale: il servizio può essere installato più volte, sulla stessa macchina o su macchine diverse, distribuendo il carico in modo modulare, con logiche di throttling per governare i picchi. La capacità cresce aggiungendo istanze, sia in ambiente Windows sia in ambiente Kubernetes/Linux.
Il risultato è un’architettura più prevedibile nei costi e più elastica nella capacità: la crescita dei workload elaborativi non trascina il dimensionamento del sistema che conserva i dati.
Uno spazio di lavoro isolato
Oltre a un servizio dedicato, l’Analytics Engine dispone di un proprio spazio di lavoro. Le query vengono eseguite in uno spazio isolato, distinto dallo spazio di lavoro principale dell’applicazione: una sorta di sandbox dedicata all’elaborazione analitica, che Irion chiama Virtual Space ed è fornita da un oggetto dedicato, AnalyticsDB.
Il ciclo di vita di questo spazio è configurabile a livello di singola pipeline o di singola richiesta. In questo modo le elaborazioni analitiche si inseriscono nel modello di esecuzione dell’applicazione senza introdurre un paradigma operativo separato: l’isolamento è garantito, la gestione resta la stessa.
Stessi paradigmi, stessa pipeline
Un motore specializzato ha valore se non obbliga a costruire un mondo a parte intorno a sé. L’Analytics Engine si usa con gli stessi paradigmi già noti a chi sviluppa su Irion EDM Application:
- DELT™ (Declarative Extract Load & Transform): il processo è rappresentato come un grafo dichiarativo; si definisce la logica dell’elaborazione e l’applicazione ne governa l’esecuzione.
- EasT™ (Everything as a Table): sorgenti diverse vengono presentate come tabelle virtuali, interrogabili in modo uniforme.
- IsolData™: governa e isola gli spazi temporanei e il ciclo di vita dei dati intermedi.
Non serve quindi un ambiente di sviluppo o di gestione separato. Soprattutto, l’Analytics Engine può interagire nella stessa esecuzione con gli altri engine di elaborazione di Irion (i Data Engine): Query, Rule, Python, R, Masking, Profiler e Script. Nella stessa pipeline può leggere e scrivere tabelle virtuali prodotte o consumate dagli altri strumenti, combinando elaborazione, qualità e distribuzione dei dati in un unico flusso.
Raggiungere i dati dove si trovano
Le architetture dati sono sempre più distribuite, e un motore analitico deve saperle attraversare. L’Analytics Engine opera direttamente su sorgenti eterogenee, senza richiedere la centralizzazione preventiva dei dati in un unico repository:
- supporta le tre principali tipologie di cloud object storage: Amazon S3, Azure Blob Storage e Google Cloud Storage;
- legge e scrive nativamente il formato Parquet, senza conversioni intermedie;
- si connette a Cloud Data Warehouse come Google BigQuery e ad architetture Lakehouse, tra cui Unity Catalog e il Lakehouse gestito da Irion;
- si integra con database relazionali e sorgenti locali, consentendo di comporre sorgenti di natura diversa nella stessa pipeline.
L’uso di formati aperti favorisce l’interoperabilità tra strumenti e permette di lavorare accanto alle piattaforme dati già adottate, valorizzandone le risorse quando opportuno e riportando i risultati nelle pipeline governate di Irion.
Pushdown: portare parte del lavoro alla sorgente
Raggiungere i dati non significa necessariamente spostarli. Quando la sorgente lo supporta, l’Analytics Engine applica logiche di pushdown: delega alla sorgente remota filtri e proiezioni, o l’intera query, riducendo il volume di dati da trasferire verso il servizio di elaborazione e valorizzando la potenza di calcolo già presente nella sorgente.
Sui file Parquet il pushdown si applica anche in lettura. Il motore applica automaticamente projection e filter pushdown: legge solo le colonne necessarie e, quando la query lo consente, utilizza i filtri per evitare di leggere porzioni di dati non rilevanti.
È utile essere precisi sul perimetro. Accesso diretto e pushdown possono ridurre staging, copie e trasferimenti non necessari, ma non li eliminano in ogni caso: alcune elaborazioni locali o cross-source richiedono comunque di trasferire o materializzare i dati. Il trasferimento effettivo dipende dalla sorgente, dalla query e dal piano di esecuzione.
Dove esprime il massimo, e dove no
L’Analytics Engine può essere utilizzato per diverse tipologie di elaborazione, ma dà il meglio sui workload intensivi: aggregazioni, trasformazioni, profilazioni e query complesse su grandi volumi. Su questi workload, coerenti con la sua architettura colonnare e vettoriale, può offrire prestazioni superiori; il risultato concreto dipende da query, dati, concorrenza, configurazione e infrastruttura.
Esiste anche un perimetro in cui non è la scelta più appropriata. Nei contesti ad alta transazionalità e concorrenza, con molti utenti che accedono o aggiornano contemporaneamente gli stessi dati, il motore tradizionale basato su SQL Server resta più adatto. È una delle ragioni per cui l’Analytics Engine affianca SQL Server: ogni elaborazione viene assegnata al motore in grado di eseguirla meglio, valorizzando i sistemi già presenti.
Un’architettura progettata per crescere
L’Analytics Engine non è un componente chiuso. La sua architettura prevede un meccanismo di estensione basato su librerie dedicate, ampliate e potenziate ad ogni release. Il motore è quindi una base su cui aggiungere progressivamente nuove funzionalità, facendo evolvere i casi d’uso senza cambiare paradigma e senza introdurre ambienti separati.
In sintesi
Sotto il cofano, l’Analytics Engine combina un modello di esecuzione colonnare e vettoriale, una gestione della memoria che prosegue su disco quando serve, un servizio di calcolo dedicato e scalabile orizzontalmente, uno spazio di lavoro isolato e una connettività nativa verso formati aperti e infrastrutture moderne. Tutto questo all’interno degli stessi paradigmi e delle stesse pipeline di Irion EDM Application.
Il principio che tiene insieme questi elementi è uno solo: far crescere il calcolo con criteri propri, senza trascinare il dimensionamento del sistema che conserva i dati, e mantenere entrambi coordinati all’interno di pipeline governate.
Irion: Turning Data into Action
FAQ
L’Analytics Engine è un motore SQL colonnare e vettoriale integrato in Irion EDM Application, progettato per workload analitici su grandi volumi di dati e sorgenti eterogenee. Affianca gli engine già disponibili in Irion EDM Application ed esegue le elaborazioni in un servizio di calcolo dedicato e isolato, all’interno delle stesse pipeline governate.
L’Analytics Engine porta con sé un insieme completo di elementi architetturali: modello colonnare e vettoriale, esecuzione in-memory con prosecuzione su disco, un servizio di esecuzione dedicato e isolato, connettività nativa verso formati e infrastrutture moderne e scalabilità orizzontale su più istanze.
L’elaborazione prosegue utilizzando il disco, con uno spill automatico che non interrompe l’esecuzione. Il motore usa la memoria quando è disponibile e ricorre al disco quando serve, senza richiedere di dimensionare l’infrastruttura sui casi limite.
Aggiungendo istanze dell’Analytics Execution Service (AES), il servizio di calcolo dedicato del motore, sulla stessa macchina o su macchine diverse. La capacità di calcolo cresce così in modo indipendente, con logiche di throttling per governare i picchi di carico.
No. L’Analytics Engine può funzionare sia in ambiente Windows sia in ambiente Kubernetes/Linux.
No. L’Analytics Engine affianca SQL Server e permette di assegnare ogni elaborazione al motore più appropriato. Nei contesti ad alta transazionalità e concorrenza, SQL Server resta la soluzione più adatta.
Non necessariamente. Accesso diretto e pushdown possono ridurre staging, copie e trasferimenti, ma alcune elaborazioni locali o cross-source richiedono comunque di trasferire o materializzare i dati. Il trasferimento effettivo dipende dalla sorgente, dalla query e dal piano di esecuzione.
Sì. L’Analytics Engine si connette a Cloud Data Warehouse come Google BigQuery, ad architetture Lakehouse e ai principali cloud object storage, lavorando accanto alle piattaforme già adottate e riportando i risultati nelle pipeline governate di Irion.