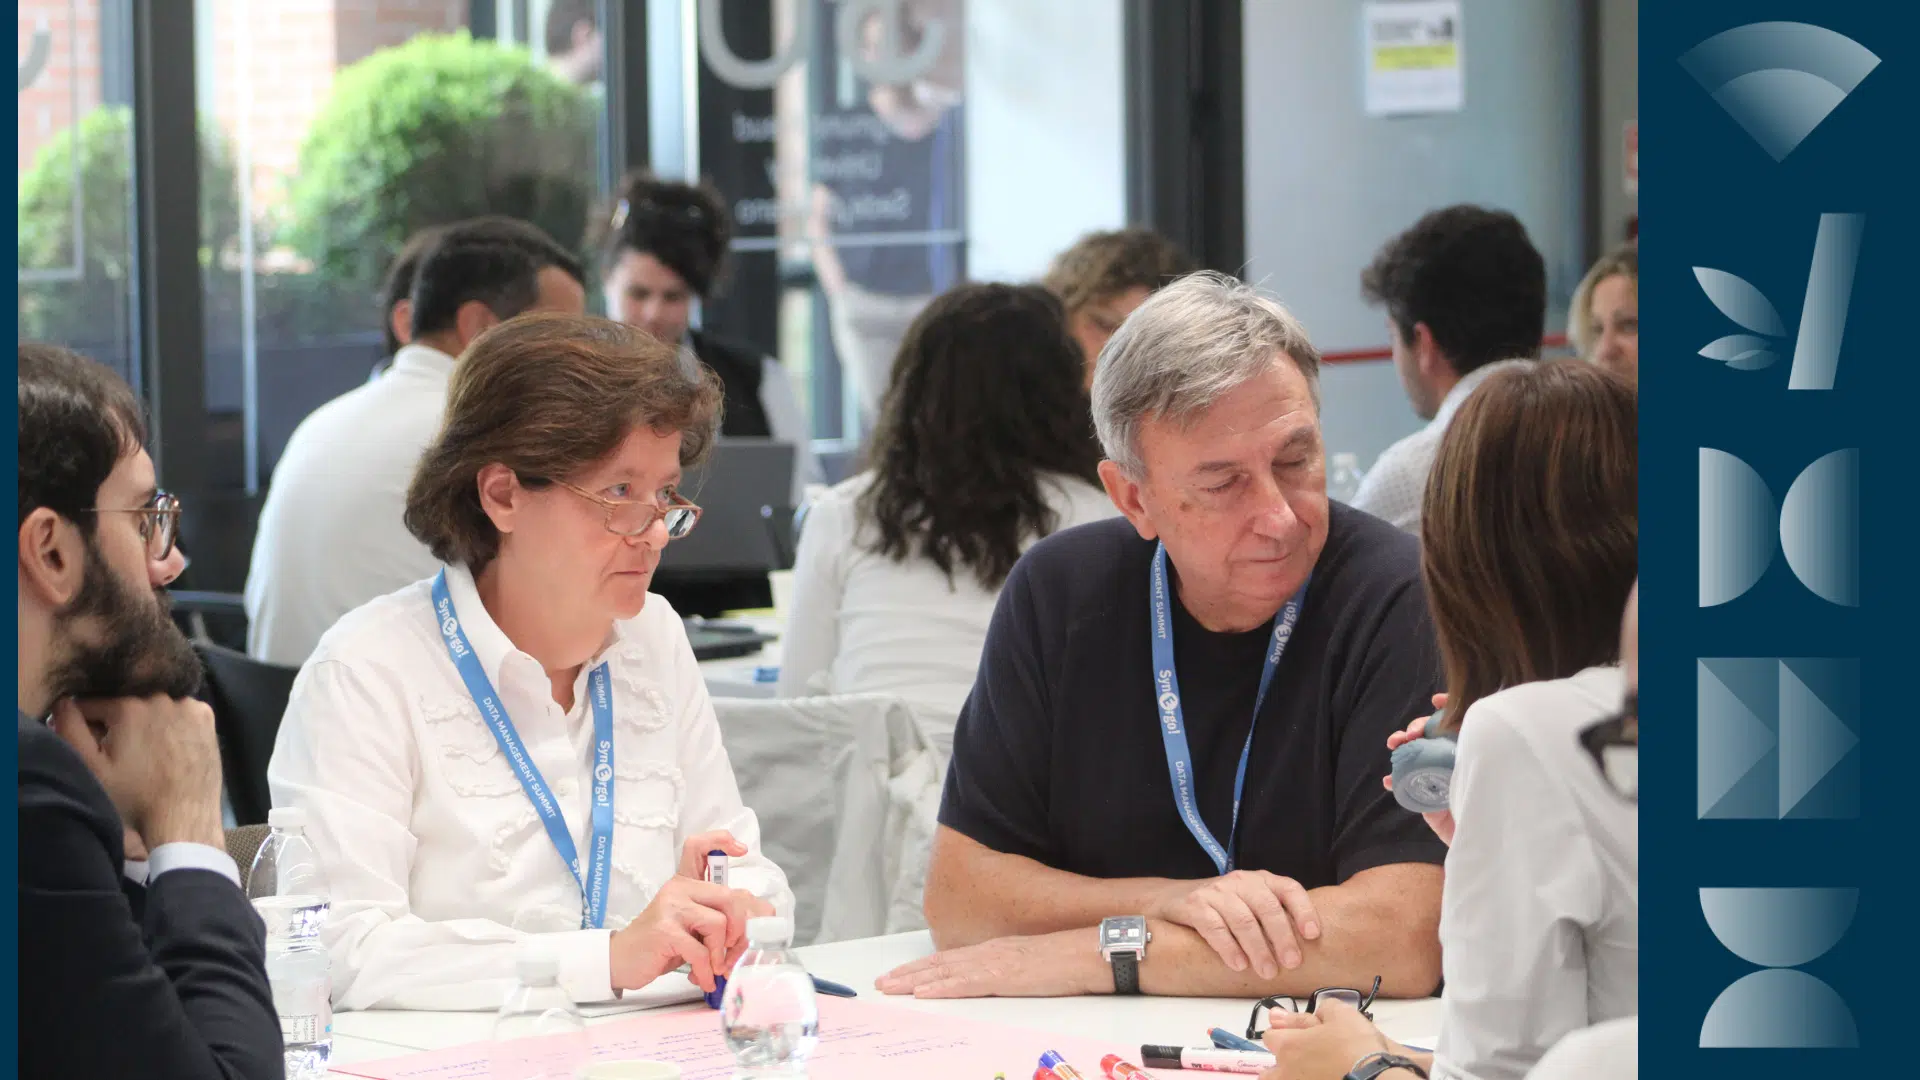
Il 17 settembre, al Data Management Summit di Milano, Lorena Crepaldi, Senior Business Consultant di Irion, ha partecipato alla tavola rotonda “Open Insurance, Cat Modeling, and Emerging Scenarios in the Insurance Industry”, moderata da Simona Di Felice (Kirey Advisory), insieme a Diego Caputo, Insurtech executive, e Fabio Schiera del Comitato Scientifico di DAMA Italia.
Lorena ha portato al confronto oltre vent’anni di esperienza nel settore assicurativo, maturata nell’implementazione di sistemi gestionali complessi in Italia e all’estero, e un focus sul Data Management come leva per valorizzare il patrimonio informativo delle compagnie. Di seguito una sintesi delle sue risposte alle due domande che le sono state rivolte.
Integrare fonti diverse per valutare il rischio catastrofale
Quali sono le difficoltà che le compagnie incontrano sul tema dei modelli catastrofali, quando provano a combinare fonti dati interne, esterne e multimodali?
Il punto di partenza, ha spiegato Lorena, è che i dati delle compagnie sono spesso frammentati, distribuiti in silos separati e talvolta provenienti da procedure datate. A questa complessità si sommano due fattori che hanno accelerato il tema negli ultimi anni. Il primo è la crescita, per frequenza e dimensione, degli eventi catastrofali, che porta le compagnie a stimare danni sempre più elevati. Il secondo è normativo: EIOPA ha evidenziato un protection gap molto disomogeneo in Europa e particolarmente elevato in Italia, e il legislatore italiano ha introdotto l’obbligo di copertura catastrofale anche per le imprese, esteso da quest’anno alle piccole e medie.
In questo contesto le stime devono diventare sempre più puntuali. Diventa necessario geolocalizzare gli asset assicurati per ottenere una mappatura capillare del territorio, e analogamente con i sinistri, così da poter mettere in relazione le informazioni per le analisi post eventi.
Le serie storiche sui sinistri restano indispensabili per definire tariffe, riserve catastrofali e trattati di riassicurazione, ma non sono più sufficienti. Occorre integrarle con indicatori di rischio e percentili di probabilità di accadimento resi disponibili da open data istituzionali, come Copernicus a livello europeo e, in Italia, INGV per i terremoti e ISPRA per alluvioni e inondazioni. Queste fonti offrono non solo dati sul passato, ma anche modelli prospettici a 10 o 20 anni. A esse si affiancano i provider di settore storicamente utilizzati dai riassicuratori, con modelli proprietari più costosi.
La sfida, secondo Lorena, è portare queste informazioni dentro i processi. In fase di underwriting, questi dati consentono un pricing dinamico e accurato, che riflette il reale livello di rischio predittivo legato alla combinazione di fattori presenti in ciascuna area. Nel risk management supportano la definizione della strategia di riassicurazione, sia per i trattati proporzionali e non, sia per la fissazione dei limiti excess of loss. Nella fase post evento, invece, permettono di stimare rapidamente l’esposizione alla perdita, ad esempio attraverso il programma di l’osservazione della terra di Copernicus. Risultano inoltre determinanti per gli stress test e per la reportistica regolamentare Solvency II, come l’ORSA.
Le fonti istituzionali sono più accessibili dal punto di vista economico, ma richiedono alle compagnie di farsi carico dell’intera gestione dei dati. Il mercato si sta muovendo: alcune compagnie hanno avviato la fase di analisi, poche sono già passate a una gestione strutturata di queste informazioni.
Integrare il patrimonio legacy mantenendolo governato nel tempo
Come si può agevolare l’integrazione dei dati legacy delle compagnie assicurative – eterogenei e spesso chiusi in silos- garantendone al contempo governo e affidabilità?
Nel settore assicurativo, ha ricordato Lorena, le acquisizioni successive hanno lasciato in eredità numerosi sistemi legacy, al punto che per lo stesso ramo possono coesistere due sistemi di emissione di portafoglio, con informazioni simili provenienti da archivi completamente diversi. La sua risposta si articola in tre livelli.
Il primo è l’integrazione: tramite l’implementazione di soluzioni che abilitano la costruzione dei prodotti dati interrogando fonti eterogenee, database, file piatti e altri formati, residenti nei diversi silos di Compagnia o di Gruppo, come se si trovassero in un unico grande database, per permetterne una gestione integrata. I data product possono poi essere resi disponibili su un marketplace, per accelerare i processi decisionali e l’analisi da parte delle funzioni del business che utilizzano quei dati.
Il secondo è il governo del dato. Con fonti frammentate e informazioni non sempre riconoscibili, è necessario dotarsi di un layer di governo che lascia i dati dove sono, ma che ne permette la gestione in termini di conoscenza e disponibilità e che ne definisce la mappatura collegandoli ad un business glossary, così da renderli comprensibili in tutta l’organizzazione.
Il terzo è la qualità. In assenza di un unico punto di riferimento, è difficile sapere quanto sia accurato il dato che arriva. Introdurre un governance layer di data quality consente il monitoraggio dei livelli di affidabilità dei dati raccogliendo gli esiti dai motori dei diversi sistemi legacy, laddove non sia conveniente la centralizzazione, offrendo una rendicontazione unitaria della qualità dei dati utilizzati.
Alcuni casi di successo: