L’Analytics Engine è il motore di Irion EDM® Application dedicato alle elaborazioni analitiche su grandi volumi e sorgenti eterogenee. Si sceglie come gli altri motori di elaborazione, all’interno delle stesse pipeline. Ecco cinque cose che permette di fare, cosa significano per chi progetta le soluzioni e cosa cambia per chi ne utilizza i risultati.
Un motore in più nella cassetta degli attrezzi
Chi progetta soluzioni in Irion EDM sceglie, passaggio dopo passaggio, lo strumento più adatto a ogni elaborazione: uno per le query, uno per le regole di qualità, uno per gli script in Python o R, uno per il mascheramento dei dati. L’Analytics Engine si aggiunge a questa famiglia con un compito preciso: le elaborazioni analitiche intensive su grandi volumi e sorgenti eterogenee.
Affianca il motore relazionale, opera come un motore SQL e lavora nelle stesse pipeline, con gli stessi strumenti. Ma il suo valore non si ferma a chi progetta: arriva fino a chi utilizza i risultati, sotto forma di analisi più ampie, indicatori più completi e tempi più compatibili con le decisioni.
Per questo ogni funzionalità, qui di seguito, è raccontata da due punti di vista: quello di chi progetta le pipeline (designer e Data Engineer) e quello di chi ne usa i risultati nel lavoro quotidiano.
1. Analizzare grandi volumi in tempi compatibili con il lavoro operativo
Aggregazioni su decine di milioni di record, scostamenti temporali, calcoli per divisa e per finestre temporali, pivot e viste comparative: sono le elaborazioni in cui l’Analytics Engine esprime il suo potenziale. Il motore legge solo i dati che servono alla singola analisi e, quando la memoria non basta, prosegue l’elaborazione senza interromperla.
Per chi progetta, significa poter assegnare i passaggi più pesanti di una pipeline al motore pensato per sostenerli, senza cambiare strumenti né modalità di lavoro.
Per chi usa i risultati, significa disporre di analisi su grandi volumi in tempi utili per agire, e non soltanto per prendere atto di ciò che è già successo.
2. Simulare e ricalcolare scenari
Le simulazioni previsionali e il ricalcolo di scenari su serie storiche sono elaborazioni iterative: si ripetono, si confrontano, si rifanno con parametri diversi. Su grandi basi dati, è proprio la ripetizione a renderle onerose.
Per chi progetta, l’Analytics Engine rende sostenibili elaborazioni di questo tipo, che in precedenza potevano richiedere tempi difficili da conciliare con le esigenze operative.
Per chi usa i risultati, significa poter confrontare più scenari e rileggere lo stesso fenomeno da angolazioni diverse, con viste comparative che ne rendono immediata la lettura.
3. Combinare sorgenti diverse senza centralizzarle prima
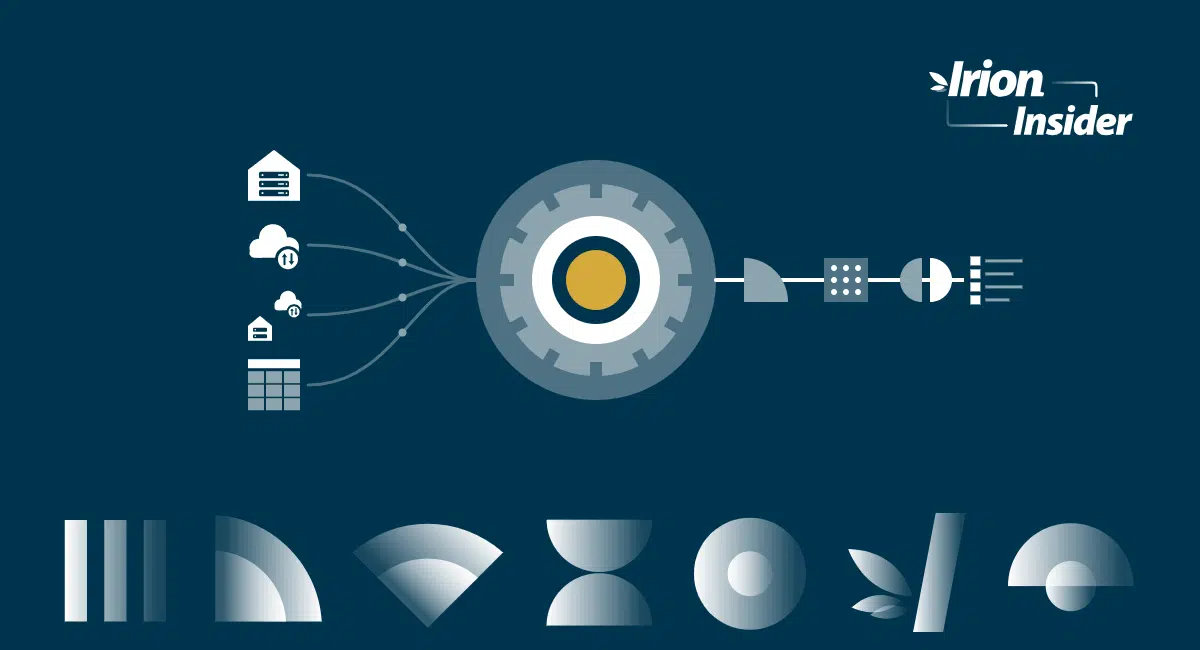
I dati di un’organizzazione vivono in luoghi diversi: database relazionali, object storage in cloud come Amazon S3, Azure Blob Storage e Google Cloud Storage, file in formato Parquet, Cloud Data Warehouse come Google BigQuery, ambienti Lakehouse. L’Analytics Engine permette di interrogarli con una logica SQL unificata, componendoli nella stessa elaborazione e leggendo e scrivendo i formati aperti senza conversioni intermedie.
Per chi progetta, questo si traduce in meno pipeline di staging, meno copie e meno connettori punto-punto da costruire e mantenere. Quando la sorgente lo consente, parte del lavoro viene delegata alla sorgente stessa, riducendo i dati da trasferire. Non sempre i dati possono restare dove sono, ma ciò che non serve spostare non viene spostato.
Per chi usa i risultati, significa disporre di indicatori che integrano fonti diverse senza dover attendere un progetto di centralizzazione preventiva, e di una vista operativa su dati distribuiti.
4. Eseguire elaborazioni pesanti senza fermare il resto
Le elaborazioni dell’Analytics Engine vengono eseguite in un servizio dedicato, separato dal resto dell’applicazione. Le analisi più impegnative restano confinate in quel perimetro, mentre gli altri servizi continuano a funzionare normalmente.
Per chi progetta, significa non dover scegliere tra analisi intensive e stabilità del sistema. E quando i volumi crescono, la potenza di calcolo può crescere a sua volta aggiungendo istanze del servizio, sia in ambiente Windows sia in ambiente Kubernetes/Linux, senza dover ridimensionare l’intera infrastruttura.
Per chi usa i risultati, significa continuità: mentre un’elaborazione pesante è in corso, le altre attività sull’applicazione proseguono senza rallentamenti.
5. Costruire un unico flusso, dall’elaborazione alla distribuzione
L’Analytics Engine non lavora in isolamento. Nella stessa pipeline può scambiare risultati con gli altri motori di elaborazione di Irion: Query, Rule, Python, R, Masking, Profiler e Script. Un flusso tipico può aggregare grandi volumi con l’Analytics Engine, applicare controlli di qualità sul risultato, mascherare i dati sensibili e distribuire l’output finale, tutto in un’unica esecuzione.
Per chi progetta, significa un solo flusso governato invece di più strumenti da orchestrare. L’Analytics Engine si usa con gli stessi paradigmi già noti a chi sviluppa su Irion EDM, come le pipeline DELT® e le tabelle virtuali di EAsT®: nessun ambiente separato, nessun linguaggio nuovo da imparare.
Per chi usa i risultati, significa ricevere dati già elaborati, controllati e pronti all’uso, con la tracciabilità garantita da pipeline governate.
Quando sceglierlo, e quando no
Il consiglio pratico per chi progetta è semplice: scegliere il motore in funzione del workload.
L’Analytics Engine dà il meglio su aggregazioni, trasformazioni, profilazioni e query complesse su grandi volumi, cioè sulle elaborazioni coerenti con la sua architettura. Nei contesti ad alta transazionalità e concorrenza, con molti utenti che accedono o aggiornano contemporaneamente gli stessi dati, il motore relazionale basato su SQL Server resta la scelta più appropriata.
Non si tratta quindi di sostituire un motore con un altro, ma di assegnare ogni elaborazione a quello in grado di eseguirla meglio, valorizzando i sistemi già presenti.
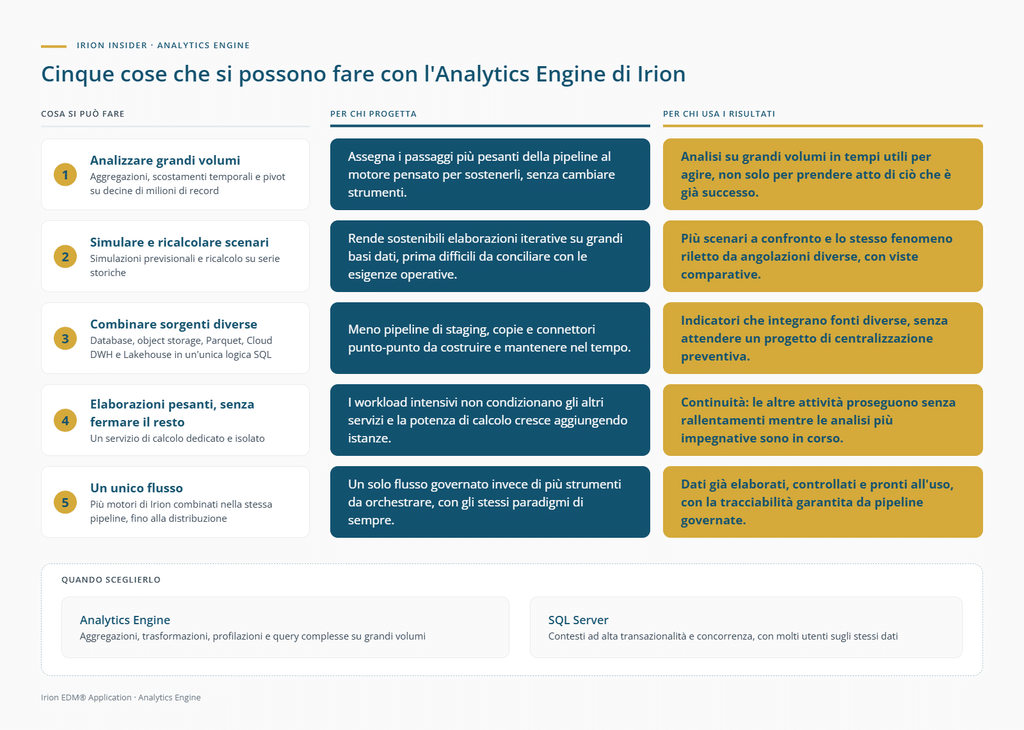
Le cinque funzionalità, viste dalle due prospettive: chi progetta le pipeline e chi ne usa i risultati.
In sintesi
L’Analytics Engine amplia ciò che si può fare in Irion EDM: analisi su grandi volumi, simulazioni, elaborazioni cross-source, workload intensivi isolati dal resto del sistema e flussi completi che combinano più motori. Per chi progetta è uno strumento in più da scegliere con criterio; per chi usa i risultati è la possibilità di avere analisi più ampie e più tempestive, all’interno di processi governati.
Per chi vuole capire cosa succede sotto la superficie, l’articolo Under the Hood Dentro l’Analytics Engine: come Irion separa il calcolo dalla persistenza ne racconta l’architettura.
FAQ
L’Analytics Engine è indicato per le elaborazioni analitiche intensive su grandi volumi e sorgenti eterogenee: aggregazioni, scostamenti temporali, pivot, simulazioni su serie storiche, trasformazioni, profilazioni e query complesse. Nei contesti ad alta transazionalità e concorrenza resta più appropriato il motore relazionale basato su SQL Server.
No. L’Analytics Engine opera come un motore SQL e si usa con gli stessi paradigmi e strumenti di Irion EDM® Application, all’interno delle stesse pipeline, senza un ambiente di sviluppo separato.
Sì. Nella stessa esecuzione l’Analytics Engine può scambiare risultati con gli altri motori di elaborazione di Irion, tra cui Query, Rule, Python, R, Masking, Profiler e Script, combinando elaborazione, controlli di qualità e distribuzione dei dati in un unico flusso.
L’Analytics Engine legge direttamente dati su object storage in cloud, file Parquet, Cloud Data Warehouse e ambienti Lakehouse. Quando la sorgente lo supporta, delega parte dell’elaborazione alla sorgente stessa, riducendo staging e copie; alcune elaborazioni cross-source possono comunque richiedere di trasferire o materializzare i dati.
No. Le elaborazioni dell’Analytics Engine vengono eseguite in un servizio dedicato e isolato, così che i workload più intensivi non interferiscano con gli altri servizi dell’applicazione.