Le architetture dati sono sempre più distribuite e i workload analitici sempre più intensivi. Per molte organizzazioni la domanda non è più soltanto dove conservare i dati, ma dove e come eseguire il calcolo: e la risposta passa dall’assegnare ogni elaborazione al motore più adatto, senza sostituire ciò che funziona.
Una nuova domanda architetturale
Per molto tempo la domanda centrale delle architetture dati è stata una sola: dove conservare i dati. Oggi gli ecosistemi aziendali sono distribuiti: database relazionali, servizi cloud, Lakehouse, Cloud Data Warehouse e file system convivono, ciascuno al servizio di esigenze diverse. In questo scenario, la capacità di combinare dati distribuiti diventa importante quanto la capacità di conservarli, e la domanda cambia: non più soltanto dove risiedono i dati, ma dove e come eseguire il calcolo analitico in modo efficiente, sostenibile e governato.
Non è una questione astratta. I database relazionali restano essenziali per persistenza, consistenza ed elaborazione transazionale. Aggregazioni massive, profilazioni, simulazioni, controlli di qualità e query cross-source hanno però caratteristiche proprie: operano su grandi quantità di dati, leggono spesso solo alcune colonne e richiedono potenza di calcolo elastica e isolata. E mentre i progetti di Intelligenza Artificiale accelerano il bisogno di dati governati e pipeline robuste, la questione non è più se modernizzare l’architettura, ma come farlo senza imporre sostituzioni complete o migrazioni big bang.
Quattro segnali di un’architettura pronta a evolvere
Il bisogno di separare il calcolo dalla persistenza raramente si presenta come una decisione a tavolino. Emerge da segnali operativi, che molte organizzazioni riconoscono nel lavoro quotidiano. Nessuno di questi indica che l’architettura attuale sia sbagliata: indicano che le esigenze sono cambiate.
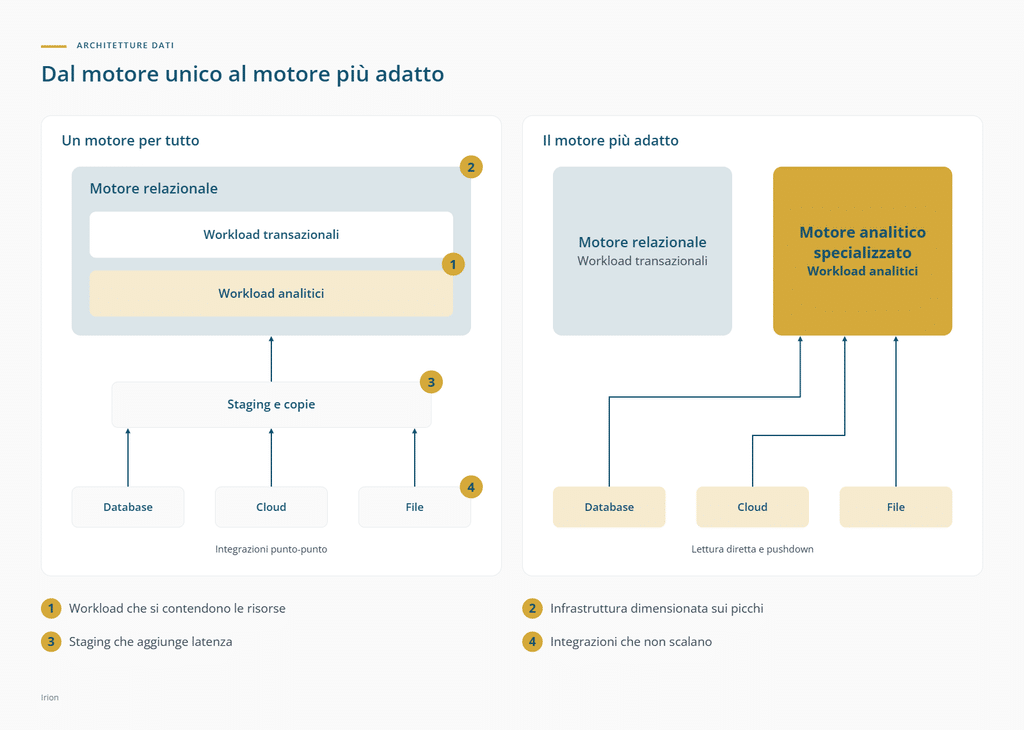
1. Workload diversi si contendono le stesse risorse.
Quando le elaborazioni analitiche crescono, finiscono per condividere risorse con i processi transazionali. Un’aggregazione su grandi volumi può allora condizionare la reattività di sistemi che devono garantire consistenza e continuità operativa. Il problema non è nessuno dei due workload in sé, ma il fatto di farli convivere sullo stesso motore.
2. L’infrastruttura relazionale cresce per sostenere le analisi.
Per reggere le elaborazioni più intensive si tende ad aumentare le risorse dei database relazionali. È una risposta comprensibile, ma porta a dimensionare l’infrastruttura sui picchi analitici, con un impatto che si riflette anche sulle licenze, spesso legate al numero di core.
3. Staging e copie aggiungono latenza senza aggiungere valore.
Spostare i dati in aree di staging o in repository intermedi prima di poterli analizzare allunga i tempi e moltiplica le copie da mantenere e governare. Ogni passaggio in più è un punto in cui il dato invecchia, si duplica o richiede controlli aggiuntivi.
4. Le integrazioni punto-punto non scalano.
Al crescere delle sorgenti, le connessioni costruite una per una diventano difficili da mantenere. Ogni nuova fonte richiede nuovo lavoro di integrazione, e combinare dati di natura diversa diventa un progetto a sé.
Lo schema mette a confronto i due modelli: un unico motore per tutti i workload, con i quattro segnali appena descritti, e la distribuzione delle elaborazioni tra motori specializzati.
Separare il calcolo dalla persistenza
La risposta a questi segnali non è sostituire ciò che funziona, ma rendere l’architettura più modulare. Il principio è semplice da enunciare: i dati restano nei sistemi più adatti a conservarli e governarli, mentre ogni elaborazione viene assegnata al motore più adatto a eseguirla. I processi transazionali continuano a girare sul motore relazionale; le elaborazioni analitiche intensive vengono affidate a un motore specializzato, progettato per leggere grandi volumi e combinare sorgenti diverse.
Separare non significa smantellare. Il database relazionale non viene sostituito né svuotato del suo ruolo: smette semplicemente di sostenere carichi che non gli sono propri. Per questo la separazione può avvenire in modo progressivo, un workload alla volta, proteggendo gli investimenti già fatti in tecnologia, processi e competenze.
Perché la separazione porti valore senza aggiungere complessità, servono però alcune condizioni.
Gli stessi strumenti e le stesse pipeline. Se il motore analitico richiede un ambiente di sviluppo a parte, nuovi linguaggi o un’orchestrazione separata, la complessità tolta da una parte rientra dall’altra. La separazione deve avvenire nel modo in cui le elaborazioni vengono eseguite, non nel modo in cui vengono progettate.
Isolamento dei workload. Le elaborazioni intensive devono girare in uno spazio dedicato, così da non condizionare la continuità degli altri servizi. È l’isolamento a risolvere la contesa di risorse, più della semplice velocità.
Crescita indipendente. La potenza di calcolo deve poter crescere con criteri propri, senza trascinare il dimensionamento del sistema che conserva i dati. È questo che permette di smettere di dimensionare l’infrastruttura relazionale sui picchi analitici.
Raggiungere i dati dove si trovano. L’uso di formati aperti e la possibilità di delegare parte dell’elaborazione alle sorgenti, quando lo consentono, riducono staging e copie. Con una precisazione: non sempre i dati possono restare dove sono, e alcune elaborazioni richiedono comunque di trasferirli o materializzarli. L’obiettivo è spostare solo ciò che serve.
Governance lungo tutto il percorso. Calcolo e persistenza possono evolvere separatamente solo se restano coordinati all’interno di pipeline governate, in cui ogni elaborazione è tracciabile e ripetibile. Una capacità analitica veloce ma non governata sposta il problema, non lo risolve.
Come decidere: alcune domande da porsi
Non esiste un momento giusto in assoluto per separare il calcolo dalla persistenza, né un’architettura di riferimento valida per tutti. Esistono però alcune domande che aiutano a capire se, dove e come intervenire.
Quali workload pesano di più, e dove girano oggi?
Mappare le elaborazioni più intensive (aggregazioni, simulazioni, controlli di qualità su grandi volumi, analisi cross-source) e il motore su cui vengono eseguite è il primo passo. Spesso pochi workload generano la maggior parte della contesa di risorse.
Dove risiedono i dati, e quanto si spostano prima di essere analizzati?
Contare i passaggi di staging, le copie intermedie e le integrazioni punto-punto dà una misura concreta di quanto l’architettura attuale costi in latenza e manutenzione.
Quanto costa far crescere l’infrastruttura attuale?
Se la crescita delle analisi si traduce in nuove risorse per il database relazionale, conviene valutare l’impatto complessivo, licenze comprese, e confrontarlo con l’alternativa di affidare quei workload a un motore dedicato. Il beneficio va verificato caso per caso, in funzione dei workload e del contesto.
Quali strumenti, processi e competenze si vogliono preservare?
Una modernizzazione sostenibile valorizza ciò che il team già conosce. Più la nuova capacità si inserisce negli strumenti esistenti, minore è il costo del cambiamento.
La governance segue le elaborazioni?
Ogni nuova capacità di calcolo deve restare dentro il perimetro di tracciabilità e controllo già in essere. Se non lo fa, crea nuove zone d’ombra proprio dove i dati vengono trasformati.
L’approccio di Irion
Irion affronta questa domanda con l’Analytics Engine, una funzionalità di Irion EDM® Application: un motore SQL specializzato per le elaborazioni analitiche su grandi volumi e sorgenti eterogenee, che affianca il motore relazionale basato su SQL Server. Le elaborazioni intensive vengono eseguite in un servizio di calcolo dedicato e isolato, la cui potenza può crescere in modo indipendente; i processi transazionali restano sul motore pensato per loro.
L’Analytics Engine si usa con gli stessi strumenti e nelle stesse pipeline già in uso in Irion EDM, insieme agli altri motori di elaborazione, senza ambienti separati. Lavora con formati aperti, si collega a cloud object storage, Cloud Data Warehouse e ambienti Lakehouse e, quando la sorgente lo consente, delega parte dell’elaborazione alla sorgente stessa. Non si propone come alternativa alle piattaforme dati già adottate, ma come una capacità che si inserisce nell’architettura esistente e riporta i risultati in pipeline governate.
In questo modo l’architettura esistente resta il punto di partenza: si aggiunge la capacità necessaria dove serve, senza rimettere in discussione i sistemi, i processi e le competenze già presenti.
Letture consigliate
FAQ
Significa lasciare i dati nei sistemi più adatti a conservarli e governarli, e affidare ogni elaborazione al motore più adatto a eseguirla. In pratica, i processi transazionali restano sul database relazionale, mentre le elaborazioni analitiche intensive vengono eseguite da un motore specializzato, con potenza di calcolo che cresce in modo indipendente.
No. Il database relazionale resta essenziale per persistenza, consistenza ed elaborazione transazionale. La modernizzazione può avvenire in modo progressivo, affiancandogli un motore specializzato per i workload analitici e spostando un workload alla volta.
I segnali più comuni sono quattro: workload analitici e transazionali che si contendono le stesse risorse; un’infrastruttura relazionale dimensionata sui picchi analitici, con impatto anche sulle licenze; pipeline di staging e copie che aggiungono latenza senza aggiungere valore; integrazioni punto-punto che non scalano al crescere delle sorgenti.
Non necessariamente. Formati aperti e la possibilità di delegare parte dell’elaborazione alle sorgenti permettono di analizzare dati distribuiti riducendo staging e copie. Alcune elaborazioni richiedono comunque di trasferire o materializzare i dati: l’obiettivo è spostare solo ciò che serve.
L’Analytics Engine è una funzionalità di Irion EDM Application: un motore SQL specializzato per le elaborazioni analitiche su grandi volumi e sorgenti eterogenee. Affianca il motore relazionale basato su SQL Server ed esegue i workload intensivi in un servizio di calcolo dedicato e isolato, all’interno delle stesse pipeline governate.
No. L’Analytics Engine affianca SQL Server e permette di assegnare ogni elaborazione al motore più appropriato. Nei contesti ad alta transazionalità e concorrenza, il motore relazionale resta la scelta più adatta.