Las arquitecturas de datos están cada vez más distribuidas y las cargas de trabajo analíticas son cada vez más intensivas. Para muchas organizaciones, la pregunta ya no es solo dónde almacenar los datos, sino dónde y cómo ejecutar el cómputo: y la respuesta pasa por asignar cada procesamiento al motor más adecuado, sin sustituir lo que funciona.
Una nueva pregunta arquitectónica
Durante mucho tiempo, la pregunta central de las arquitecturas de datos fue una sola: dónde almacenar los datos. Hoy los ecosistemas empresariales son distribuidos: bases de datos relacionales, servicios cloud, Lakehouses, Cloud Data Warehouses y sistemas de archivos conviven, cada uno al servicio de necesidades distintas. En este escenario, la capacidad de combinar datos distribuidos se vuelve tan importante como la capacidad de almacenarlos, y la pregunta cambia: ya no solo dónde residen los datos, sino dónde y cómo ejecutar el cómputo analítico de forma eficiente, sostenible y gobernada.
No es una cuestión abstracta. Las bases de datos relacionales siguen siendo esenciales para la persistencia, la consistencia y el procesamiento transaccional. Sin embargo, las agregaciones masivas, los perfilados, las simulaciones, los controles de calidad y las consultas cross-source tienen características propias: operan sobre grandes volúmenes de datos, a menudo leen solo algunas columnas y requieren una capacidad de cómputo elástica y aislada. Y mientras los proyectos de Inteligencia Artificial aceleran la necesidad de datos gobernados y pipelines robustos, la cuestión ya no es si modernizar la arquitectura, sino cómo hacerlo sin imponer sustituciones completas ni migraciones big bang.
Cuatro señales de una arquitectura lista para evolucionar
La necesidad de separar el cómputo del almacenamiento rara vez surge como una decisión tomada sobre el papel. Emerge de señales operativas que muchas organizaciones reconocen en su trabajo diario. Ninguna de ellas indica que la arquitectura actual sea errónea: indican que las necesidades han cambiado.
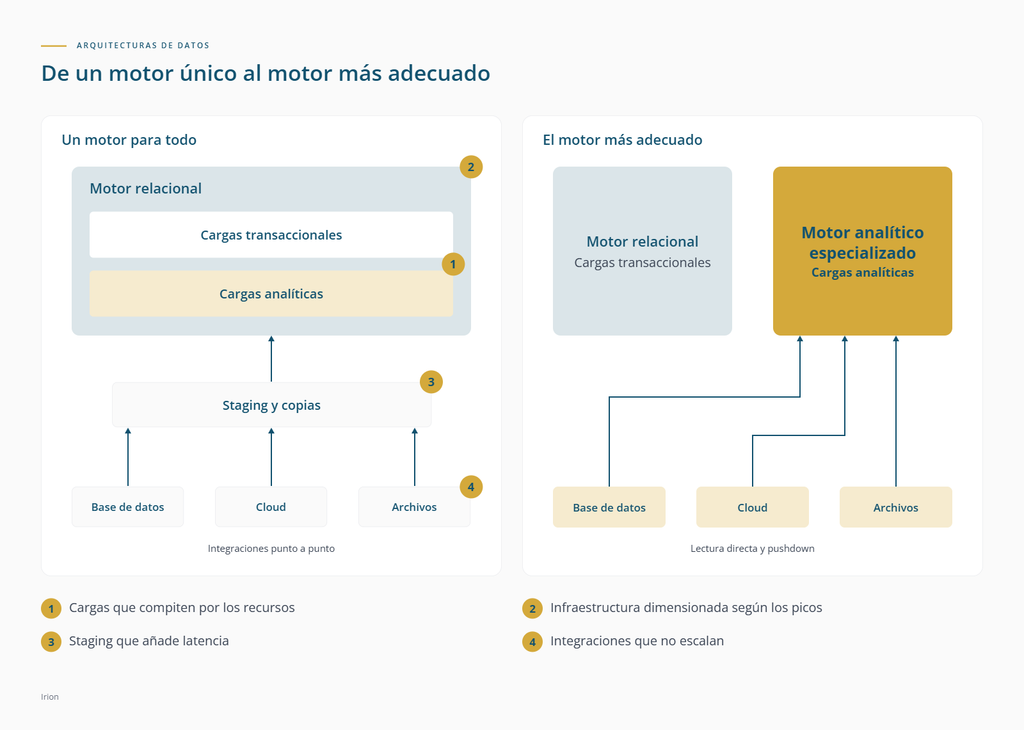
1. Distintas cargas de trabajo compiten por los mismos recursos.
Cuando el procesamiento analítico crece, acaba compartiendo recursos con los procesos transaccionales. Una agregación sobre grandes volúmenes puede entonces afectar a la capacidad de respuesta de sistemas que deben garantizar consistencia y continuidad operativa. El problema no es ninguna de las dos cargas de trabajo en sí, sino hacerlas convivir en el mismo motor.
2. La infraestructura relacional crece para sostener los análisis.
Para soportar el procesamiento más intensivo, se tiende a aumentar los recursos de las bases de datos relacionales. Es una respuesta comprensible, pero lleva a dimensionar la infraestructura según los picos analíticos, con un impacto que se refleja también en las licencias, a menudo vinculadas al número de núcleos.
3. El staging y las copias añaden latencia sin añadir valor.
Mover los datos a áreas de staging o a repositorios intermedios antes de poder analizarlos alarga los tiempos y multiplica las copias que hay que mantener y gobernar. Cada paso adicional es un punto en el que el dato envejece, se duplica o requiere controles adicionales.
4. Las integraciones punto a punto no escalan.
A medida que crecen las fuentes, las conexiones construidas una a una se vuelven difíciles de mantener. Cada nueva fuente requiere un nuevo trabajo de integración, y combinar datos de distinta naturaleza se convierte en un proyecto en sí mismo.
El esquema compara los dos modelos: un único motor para todas las cargas de trabajo, con las cuatro señales que acabamos de describir, y la distribución del procesamiento entre motores especializados.
Separar el cómputo del almacenamiento
La respuesta a estas señales no es sustituir lo que funciona, sino hacer la arquitectura más modular. El principio es sencillo de enunciar: los datos permanecen en los sistemas más adecuados para almacenarlos y gobernarlos, mientras que cada procesamiento se asigna al motor más adecuado para ejecutarlo. Los procesos transaccionales siguen ejecutándose en el motor relacional; el procesamiento analítico intensivo se confía a un motor especializado, diseñado para leer grandes volúmenes y combinar fuentes distintas.
Separar no significa desmantelar. La base de datos relacional no se sustituye ni se vacía de su función: simplemente deja de soportar cargas que no le son propias. Por eso la separación puede producirse de forma progresiva, una carga de trabajo cada vez, protegiendo las inversiones ya realizadas en tecnología, procesos y competencias.
Para que la separación aporte valor sin añadir complejidad, sin embargo, se necesitan algunas condiciones.
Las mismas herramientas y los mismos pipelines. Si el motor analítico requiere un entorno de desarrollo aparte, nuevos lenguajes o una orquestación separada, la complejidad que se elimina por un lado vuelve a entrar por el otro. La separación debe producirse en la forma en que se ejecuta el procesamiento, no en la forma en que se diseña.
Aislamiento de las cargas de trabajo. El procesamiento intensivo debe ejecutarse en un espacio dedicado, para no afectar a la continuidad de los demás servicios. Es el aislamiento, más que la simple velocidad, lo que resuelve la competencia por los recursos.
Escalado independiente. La capacidad de cómputo debe poder crecer con criterios propios, sin arrastrar el dimensionamiento del sistema que almacena los datos. Esto es lo que permite dejar de dimensionar la infraestructura relacional según los picos analíticos.
Llegar a los datos donde están. El uso de formatos abiertos y la posibilidad de delegar parte del procesamiento en las fuentes, cuando lo permiten, reducen el staging y las copias. Con una precisión: los datos no siempre pueden quedarse donde están, y algunos procesamientos siguen requiriendo transferirlos o materializarlos. El objetivo es mover solo lo necesario.
Gobierno a lo largo de todo el recorrido. El cómputo y el almacenamiento pueden evolucionar por separado solo si permanecen coordinados dentro de pipelines gobernados, en los que cada procesamiento es trazable y repetible. Una capacidad analítica rápida pero no gobernada desplaza el problema, no lo resuelve.
Cómo decidir: algunas preguntas que plantearse
No existe un momento adecuado en términos absolutos para separar el cómputo del almacenamiento, ni una arquitectura de referencia válida para todos. Existen, sin embargo, algunas preguntas que ayudan a entender si, dónde y cómo intervenir.
¿Qué cargas de trabajo pesan más y dónde se ejecutan hoy?
Mapear el procesamiento más intensivo (agregaciones, simulaciones, controles de calidad sobre grandes volúmenes, análisis cross-source) y el motor en el que se ejecuta es el primer paso. A menudo, unas pocas cargas de trabajo generan la mayor parte de la competencia por los recursos.
¿Dónde residen los datos y cuánto se mueven antes de ser analizados?
Contar los pasos de staging, las copias intermedias y las integraciones punto a punto da una medida concreta de lo que la arquitectura actual cuesta en latencia y mantenimiento.
¿Cuánto cuesta hacer crecer la infraestructura actual?
Si el crecimiento de los análisis se traduce en nuevos recursos para la base de datos relacional, conviene evaluar el impacto global, licencias incluidas, y compararlo con la alternativa de confiar esas cargas de trabajo a un motor dedicado. El beneficio debe verificarse caso por caso, en función de las cargas de trabajo y del contexto.
¿Qué herramientas, procesos y competencias se quieren preservar?
Una modernización sostenible aprovecha lo que el equipo ya conoce. Cuanto más se integra la nueva capacidad en las herramientas existentes, menor es el coste del cambio.
¿El gobierno sigue al procesamiento?
Toda nueva capacidad de cómputo debe permanecer dentro del perímetro de trazabilidad y control ya existente. Si no lo hace, crea nuevas zonas de sombra precisamente donde se transforman los datos.
El enfoque de Irion
Irion aborda esta pregunta con el Analytics Engine, una funcionalidad de Irion EDM® Application: un motor SQL especializado en el procesamiento analítico sobre grandes volúmenes y fuentes heterogéneas, que trabaja junto al motor relacional basado en SQL Server. El procesamiento intensivo se ejecuta en un servicio de cómputo dedicado y aislado, cuya capacidad puede crecer de forma independiente; los procesos transaccionales permanecen en el motor pensado para ellos.
El Analytics Engine se utiliza con las mismas herramientas y en los mismos pipelines que ya se usan en Irion EDM, junto con los demás motores de procesamiento, sin entornos separados. Trabaja con formatos abiertos, se conecta a cloud object storage, Cloud Data Warehouses y arquitecturas Lakehouse y, cuando la fuente lo permite, delega parte del procesamiento en la propia fuente. No se plantea como alternativa a las plataformas de datos ya adoptadas, sino como una capacidad que se integra en la arquitectura existente y devuelve los resultados a pipelines gobernados.
De este modo, la arquitectura existente sigue siendo el punto de partida: se añade la capacidad necesaria donde hace falta, sin poner en cuestión los sistemas, los procesos y las competencias ya presentes.
Lecturas recomendadas
FAQ
Significa dejar los datos en los sistemas más adecuados para almacenarlos y gobernarlos, y asignar cada procesamiento al motor más adecuado para ejecutarlo. En la práctica, los procesos transaccionales permanecen en la base de datos relacional, mientras que el procesamiento analítico intensivo lo ejecuta un motor especializado, con una capacidad de cómputo que crece de forma independiente.
No. La base de datos relacional sigue siendo esencial para la persistencia, la consistencia y el procesamiento transaccional. La modernización puede producirse de forma progresiva, incorporando junto a ella un motor especializado para las cargas de trabajo analíticas y trasladando una carga de trabajo cada vez.
Las señales más comunes son cuatro: cargas de trabajo analíticas y transaccionales que compiten por los mismos recursos; una infraestructura relacional dimensionada según los picos analíticos, con impacto también en las licencias; pipelines de staging y copias que añaden latencia sin añadir valor; integraciones punto a punto que no escalan a medida que crecen las fuentes.
No necesariamente. Los formatos abiertos y la posibilidad de delegar parte del procesamiento en las fuentes permiten analizar datos distribuidos reduciendo el staging y las copias. Algunos procesamientos siguen requiriendo transferir o materializar los datos: el objetivo es mover solo lo necesario.
El Analytics Engine es una funcionalidad de Irion EDM Application: un motor SQL especializado en el procesamiento analítico sobre grandes volúmenes y fuentes heterogéneas. Trabaja junto al motor relacional basado en SQL Server y ejecuta las cargas de trabajo intensivas en un servicio de cómputo dedicado y aislado, dentro de los mismos pipelines gobernados.
No. El Analytics Engine trabaja junto a SQL Server y permite asignar cada procesamiento al motor más apropiado. En contextos de alta transaccionalidad y concurrencia, el motor relacional sigue siendo la opción más adecuada.