Un motor SQL columnar y vectorial que se ejecuta en un servicio de cómputo dedicado y aislado, se integra en los pipelines de Irion EDM® Application sin requerir entornos de desarrollo separados y llega a los datos donde están.
Una mirada a la arquitectura del Analytics Engine: cómo procesa grandes volúmenes, cómo gestiona la memoria, cómo escala y cómo colabora con las demás herramientas de procesamiento.
Por qué un motor especializado
Las cargas de trabajo analíticas tienen una forma propia. El motor relacional de Irion EDM gestiona con buen rendimiento procesos sobre volúmenes importantes, incluso con muchos usuarios que acceden simultáneamente a los mismos datos, garantizando consistencia y control de la concurrencia. Los procesos analíticos sobre volúmenes aún mayores siguen típicamente un modelo distinto: leen pocas columnas sobre un número muy elevado de filas, agregan, comparan ventanas temporales y combinan fuentes diferentes.
Son necesidades estructuralmente distintas y, cuando comparten los mismos recursos, el crecimiento de una puede condicionar la estabilidad de la otra. No por un límite del motor relacional, sino porque los dos tipos de procesamiento piden cosas diferentes a la infraestructura.
El Analytics Engine nace de esta constatación. Es un motor SQL columnar y vectorial, integrado en Irion EDM Application, que trabaja junto al motor tradicional basado en SQL Server y permite asignar cada proceso al motor más adecuado. El dato permanece en el sistema más adecuado para almacenarlo y gobernarlo; el cómputo se ejecuta donde es más eficaz. Cómputo y almacenamiento pueden así evolucionar con criterios independientes, manteniéndose coordinados dentro de pipelines gobernados.
Para quien lo usa, el paradigma sigue siendo familiar: el Analytics Engine se usa igual que el Query Engine. Lo que cambia es cómo se realiza el procesamiento bajo el capó.
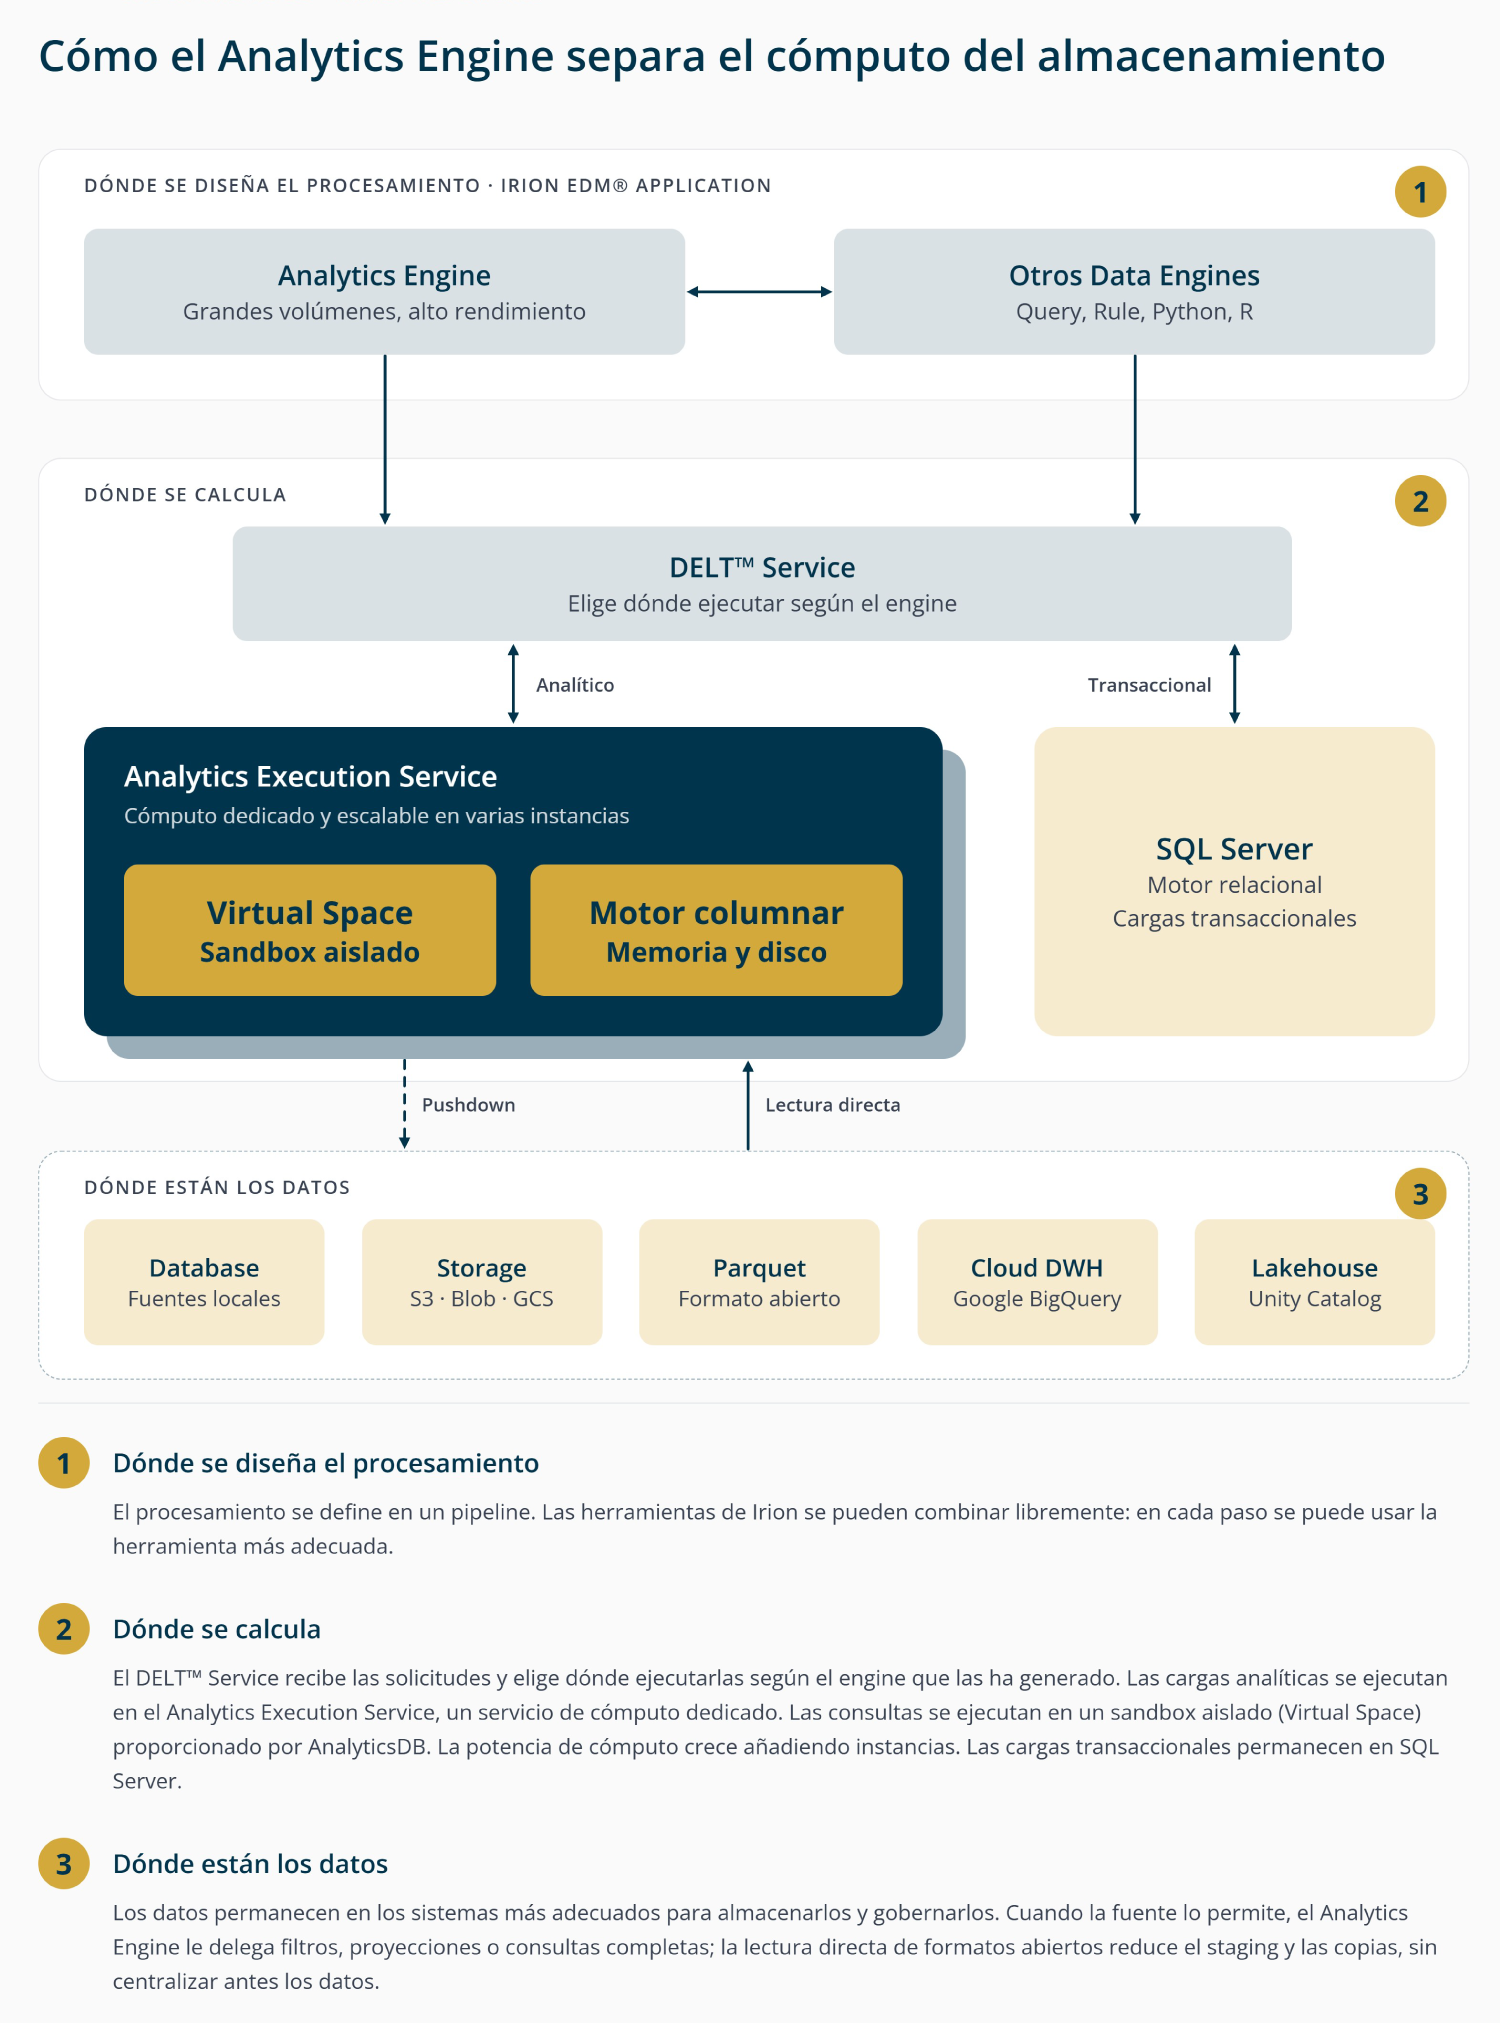
El esquema siguiente muestra cómo se distribuyen los roles: dónde se diseñan los procesos, dónde se ejecutan y dónde residen los datos.
Leer por columnas, calcular por vectores
El primer elemento de la arquitectura es el modelo de ejecución. En un modelo por filas, adecuado para las operaciones transaccionales, una consulta lee los registros completos aunque solo se necesiten unos pocos campos. El Analytics Engine, en cambio, procesa los datos en bloques columnares: lee solo las columnas que la consulta necesita, no el registro completo.
Sobre esta base se apoya la ejecución vectorial. Las operaciones no se aplican valor por valor, sino sobre vectores de valores: sumas, medias, agrupaciones, ventanas temporales y pivotes se procesan por bloques. El modelo es coherente con la forma típica de los procesos sobre grandes datasets, en los que se leen pocas columnas sobre muchísimas filas.
El efecto práctico es fácil de enunciar: menos trabajo innecesario para producir más resultado útil. Esta arquitectura muestra su potencial en los procesos de alta intensidad (agregaciones sobre decenas de millones de registros, desviaciones temporales, pivotes, simulaciones sobre series históricas), ampliando el abanico de cargas de trabajo que se pueden gestionar en los tiempos del trabajo operativo.
Un uso eficiente de los recursos
El segundo elemento es la gestión de los recursos. El Analytics Engine aprovecha la memoria para acelerar el procesamiento, pero no depende exclusivamente de ella: cuando el dataset supera la RAM disponible, el motor continúa utilizando el disco, con un spill automático que no interrumpe la ejecución.
La consecuencia es sobre todo arquitectónica. El motor se adapta al tamaño de la carga de trabajo: usa la memoria cuando está disponible y recurre al disco cuando es necesario. Por lo tanto, no hace falta dimensionar la infraestructura para los casos límite para garantizar que los procesos más pesados lleguen a completarse.
Un servicio de cómputo dedicado
El Analytics Engine no comparte recursos con el resto de la aplicación. Los procesos se ejecutan en un servicio de cómputo dedicado, separado de los demás servicios de la aplicación: el Analytics Execution Service (AES).
En el léxico del sector, se trata de una ejecución out-of-process. Una agregación sobre decenas de millones de registros queda confinada en el perímetro del servicio, mientras el resto del sistema sigue funcionando sin impacto. El aislamiento preserva la capacidad de respuesta y la continuidad de los demás servicios de la aplicación, incluso cuando el motor analítico trabaja a pleno rendimiento.
El mismo diseño hace que la potencia de cómputo escale de forma independiente. No existe un servidor central: el servicio puede instalarse varias veces, en la misma máquina o en máquinas distintas, distribuyendo la carga de forma modular, con lógicas de throttling para gestionar los picos. La capacidad crece añadiendo instancias, tanto en entornos Windows como en entornos Kubernetes/Linux.
El resultado es una arquitectura más previsible en los costes y más elástica en la capacidad: el crecimiento de las cargas de procesamiento no arrastra el dimensionamiento del sistema que almacena los datos.
Un espacio de trabajo aislado
Además de un servicio dedicado, el Analytics Engine dispone de su propio espacio de trabajo. Las consultas se ejecutan en un espacio aislado, distinto del espacio de trabajo principal de la aplicación: una especie de sandbox dedicado al procesamiento analítico, que Irion llama Virtual Space y que proporciona un objeto dedicado, AnalyticsDB.
El ciclo de vida de este espacio se puede configurar para cada pipeline o para cada solicitud. Así, los procesos analíticos se integran en el modelo de ejecución de la aplicación sin introducir un paradigma operativo separado: el aislamiento está garantizado y la gestión sigue siendo la misma.
Mismos paradigmas, mismo pipeline
Un motor especializado aporta valor si no obliga a construir un mundo aparte a su alrededor. El Analytics Engine se usa con los mismos paradigmas que ya conoce quien desarrolla en Irion EDM Application:
- DELT™ (Declarative Extract Load & Transform): el proceso se representa como un grafo declarativo; se define la lógica del procesamiento y la aplicación gobierna su ejecución.
- EasT™ (Everything as a Table): fuentes diferentes se presentan como tablas virtuales, consultables de forma uniforme.
- IsolData™: gobierna y aísla los espacios temporales y el ciclo de vida de los datos intermedios.
No hace falta, por tanto, un entorno de desarrollo o de gestión separado. Sobre todo, el Analytics Engine puede interactuar en la misma ejecución con los demás engines de procesamiento de Irion (los Data Engines): Query, Rule, Python, R, Masking, Profiler y Script. En el mismo pipeline puede leer y escribir tablas virtuales producidas o consumidas por las demás herramientas, combinando procesamiento, calidad y distribución de los datos en un único flujo.
Llegar a los datos donde están
Las arquitecturas de datos están cada vez más distribuidas, y un motor analítico tiene que saber recorrerlas. El Analytics Engine opera directamente sobre fuentes heterogéneas, sin requerir la centralización previa de los datos en un único repositorio:
- es compatible con los tres principales tipos de cloud object storage: Amazon S3, Azure Blob Storage y Google Cloud Storage;
- lee y escribe de forma nativa el formato Parquet, sin conversiones intermedias;
- se conecta a Cloud Data Warehouses como Google BigQuery y a arquitecturas Lakehouse, entre ellas Unity Catalog y el Lakehouse gestionado por Irion;
- se integra con bases de datos relacionales y fuentes locales, lo que permite combinar fuentes de naturaleza diferente en el mismo pipeline.
El uso de formatos abiertos favorece la interoperabilidad entre herramientas y permite trabajar junto a las plataformas de datos ya adoptadas, aprovechando sus recursos cuando conviene y llevando los resultados a los pipelines gobernados de Irion.
Pushdown: llevar parte del trabajo a la fuente
Llegar a los datos no significa necesariamente moverlos. Cuando la fuente lo admite, el Analytics Engine aplica lógicas de pushdown: delega en la fuente remota filtros y proyecciones, o la consulta completa. Así reduce el volumen de datos que se transfieren al servicio de procesamiento y aprovecha la potencia de cómputo ya presente en la fuente.
En los archivos Parquet, el pushdown se aplica también en lectura. El motor aplica automáticamente projection y filter pushdown: lee solo las columnas necesarias y, cuando la consulta lo permite, utiliza los filtros para evitar leer partes de los datos no relevantes.
Conviene ser precisos sobre el perímetro. El acceso directo y el pushdown pueden reducir staging, copias y transferencias innecesarias, pero no los eliminan en todos los casos: algunos procesos locales o cross-source siguen requiriendo transferir o materializar los datos. La transferencia efectiva depende de la fuente, de la consulta y del plan de ejecución.
Dónde da lo mejor de sí, y dónde no
El Analytics Engine puede utilizarse para distintos tipos de procesamiento, pero da lo mejor de sí en las cargas de trabajo intensivas: agregaciones, transformaciones, perfilados y consultas complejas sobre grandes volúmenes. En estas cargas, coherentes con su arquitectura columnar y vectorial, puede ofrecer un rendimiento superior; el resultado concreto depende de las consultas, los datos, la concurrencia, la configuración y la infraestructura.
Existe también un perímetro en el que no es la opción más adecuada. En contextos de alta transaccionalidad y concurrencia, con muchos usuarios que acceden o actualizan simultáneamente los mismos datos, el motor tradicional basado en SQL Server sigue siendo el más adecuado. Es una de las razones por las que el Analytics Engine trabaja junto a SQL Server: cada proceso se asigna al motor capaz de ejecutarlo mejor, aprovechando los sistemas ya existentes.
Una arquitectura diseñada para crecer
El Analytics Engine no es un componente cerrado. Su arquitectura prevé un mecanismo de extensión basado en librerías dedicadas, ampliadas y mejoradas en cada release. El motor es, por tanto, una base sobre la que añadir progresivamente nuevas funcionalidades, haciendo evolucionar los casos de uso sin cambiar de paradigma y sin introducir entornos separados.
En síntesis
Bajo el capó, el Analytics Engine combina un modelo de ejecución columnar y vectorial, una gestión de la memoria que continúa en disco cuando es necesario, un servicio de cómputo dedicado y escalable horizontalmente, un espacio de trabajo aislado y una conectividad nativa con formatos abiertos e infraestructuras modernas. Todo ello dentro de los mismos paradigmas y de los mismos pipelines de Irion EDM Application.
El principio que une estos elementos es uno solo: hacer crecer el cómputo con criterios propios, sin arrastrar el dimensionamiento del sistema que almacena los datos, y mantener ambos coordinados dentro de pipelines gobernados.
Irion: Turning Data into Action
FAQ
El Analytics Engine es un motor SQL columnar y vectorial integrado en Irion EDM Application, diseñado para cargas de trabajo analíticas sobre grandes volúmenes de datos y fuentes heterogéneas. Trabaja junto a los engines ya disponibles en Irion EDM Application y ejecuta los procesos en un servicio de cómputo dedicado y aislado, dentro de los mismos pipelines gobernados.
El Analytics Engine aporta un conjunto completo de elementos arquitectónicos: modelo columnar y vectorial, ejecución in-memory que continúa en disco, un servicio de ejecución dedicado y aislado, conectividad nativa con formatos e infraestructuras modernas y escalabilidad horizontal en varias instancias.
El procesamiento continúa utilizando el disco, con un spill automático que no interrumpe la ejecución. El motor usa la memoria cuando está disponible y recurre al disco cuando es necesario, sin requerir dimensionar la infraestructura para los casos límite.
Añadiendo instancias del Analytics Execution Service (AES), el servicio de cómputo dedicado del motor, en la misma máquina o en máquinas distintas. La capacidad de cómputo crece así de forma independiente, con lógicas de throttling para gestionar los picos de carga.
No. El Analytics Engine puede funcionar tanto en entornos Windows como en entornos Kubernetes/Linux.
No. El Analytics Engine trabaja junto a SQL Server y permite asignar cada proceso al motor más adecuado. En contextos de alta transaccionalidad y concurrencia, SQL Server sigue siendo la solución más adecuada.
No necesariamente. El acceso directo y el pushdown pueden reducir staging, copias y transferencias, pero algunos procesos locales o cross-source siguen requiriendo transferir o materializar los datos. La transferencia efectiva depende de la fuente, de la consulta y del plan de ejecución.
Sí. El Analytics Engine se conecta a Cloud Data Warehouses como Google BigQuery, a arquitecturas Lakehouse y a los principales cloud object storage, trabajando junto a las plataformas ya adoptadas y llevando los resultados a los pipelines gobernados de Irion.