El Analytics Engine es el motor de Irion EDM® Application dedicado al procesamiento analítico sobre grandes volúmenes y fuentes heterogéneas. Se elige como los demás motores de procesamiento, dentro de los mismos pipelines. Estas son cinco cosas que permite hacer, lo que significan para quienes diseñan las soluciones y lo que cambia para quienes utilizan sus resultados.
Un motor más en la caja de herramientas
Quienes diseñan soluciones en Irion EDM eligen, paso a paso, la herramienta más adecuada para cada procesamiento: una para las consultas, una para las reglas de calidad, una para los scripts en Python o R, una para el enmascaramiento de los datos. El Analytics Engine se suma a esta familia con una tarea precisa: el procesamiento analítico intensivo sobre grandes volúmenes y fuentes heterogéneas.
Trabaja junto al motor relacional, opera como un motor SQL y trabaja en los mismos pipelines, con las mismas herramientas. Pero su valor no se detiene en quienes diseñan: llega hasta quienes utilizan los resultados, en forma de análisis más amplios, indicadores más completos y tiempos más compatibles con las decisiones.
Por eso cada funcionalidad, a continuación, se describe desde dos puntos de vista: el de quienes diseñan los pipelines (diseñadores y Data Engineers) y el de quienes utilizan sus resultados en su trabajo diario.
1. Analizar grandes volúmenes en tiempos compatibles con el trabajo operativo
Agregaciones sobre decenas de millones de registros, desviaciones temporales, cálculos por divisa y por ventanas temporales, pivots y vistas comparativas: estos son los procesamientos en los que el Analytics Engine expresa su potencial. El motor lee solo los datos necesarios para cada análisis y, cuando la memoria no es suficiente, continúa el procesamiento sin interrumpirlo.
Para quienes diseñan, significa poder asignar los pasos más pesados de un pipeline al motor pensado para soportarlos, sin cambiar de herramientas ni de forma de trabajar.
Para quienes utilizan los resultados, significa disponer de análisis sobre grandes volúmenes en tiempos útiles para actuar, y no solo para constatar lo que ya ha sucedido.
2. Simular y recalcular escenarios
Las simulaciones de previsión y el recálculo de escenarios sobre series históricas son procesamientos iterativos: se repiten, se comparan y se rehacen con parámetros diferentes. Sobre grandes bases de datos, es precisamente la repetición lo que los hace costosos.
Para quienes diseñan, el Analytics Engine hace sostenibles procesamientos de este tipo, que anteriormente podían requerir tiempos difíciles de conciliar con las necesidades operativas.
Para quienes utilizan los resultados, significa poder comparar varios escenarios y releer el mismo fenómeno desde ángulos diferentes, con vistas comparativas que hacen inmediata su lectura.
3. Combinar fuentes diferentes sin centralizarlas antes
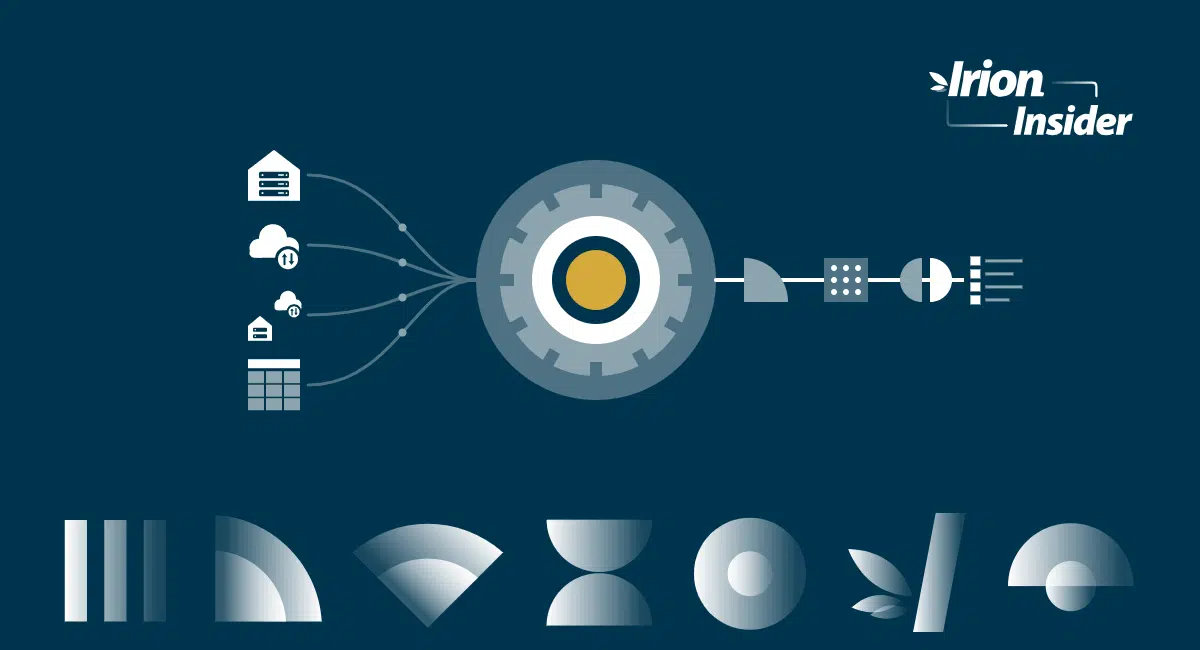
Los datos de una organización residen en lugares diferentes: bases de datos relacionales, object storage en la nube como Amazon S3, Azure Blob Storage y Google Cloud Storage, archivos en formato Parquet, Cloud Data Warehouses como Google BigQuery, entornos Lakehouse. El Analytics Engine permite consultarlos con una lógica SQL unificada, combinándolos en el mismo procesamiento y leyendo y escribiendo los formatos abiertos sin conversiones intermedias.
Para quienes diseñan, esto se traduce en menos pipelines de staging, menos copias y menos conectores punto a punto que construir y mantener. Cuando la fuente lo permite, parte del trabajo se delega a la propia fuente, reduciendo los datos que hay que transferir. No siempre los datos pueden quedarse donde están, pero lo que no es necesario mover no se mueve.
Para quienes utilizan los resultados, significa disponer de indicadores que integran fuentes diferentes sin tener que esperar a un proyecto de centralización previa, y de una vista operativa sobre datos distribuidos.
4. Ejecutar procesamientos pesados sin detener el resto
Los procesamientos del Analytics Engine se ejecutan en un servicio dedicado, separado del resto de la aplicación. Los análisis más exigentes quedan confinados en ese perímetro, mientras los demás servicios siguen funcionando con normalidad.
Para quienes diseñan, significa no tener que elegir entre análisis intensivos y estabilidad del sistema. Y cuando los volúmenes crecen, la potencia de cálculo puede crecer a su vez añadiendo instancias del servicio, tanto en entornos Windows como en entornos Kubernetes/Linux, sin tener que redimensionar toda la infraestructura.
Para quienes utilizan los resultados, significa continuidad: mientras un procesamiento pesado está en curso, las demás actividades en la aplicación continúan sin ralentizaciones.
5. Construir un único flujo, del procesamiento a la distribución
El Analytics Engine no trabaja de forma aislada. En el mismo pipeline puede intercambiar resultados con los demás motores de procesamiento de Irion: Query, Rule, Python, R, Masking, Profiler y Script. Un flujo típico puede agregar grandes volúmenes con el Analytics Engine, aplicar controles de calidad sobre el resultado, enmascarar los datos sensibles y distribuir el output final, todo en una única ejecución.
Para quienes diseñan, significa un solo flujo gobernado en lugar de varias herramientas que orquestar. El Analytics Engine se utiliza con los mismos paradigmas ya conocidos por quienes desarrollan sobre Irion EDM, como los pipelines DELT® y las tablas virtuales de EAsT®: ningún entorno separado, ningún lenguaje nuevo que aprender.
Para quienes utilizan los resultados, significa recibir datos ya procesados, controlados y listos para usar, con la trazabilidad garantizada por pipelines gobernados.
Cuándo elegirlo, y cuándo no
El consejo práctico para quienes diseñan es sencillo: elegir el motor en función del workload.
El Analytics Engine ofrece lo mejor de sí en agregaciones, transformaciones, perfilados y consultas complejas sobre grandes volúmenes, es decir, en los procesamientos coherentes con su arquitectura. En los contextos de alta transaccionalidad y concurrencia, con muchos usuarios que acceden o actualizan simultáneamente los mismos datos, el motor relacional basado en SQL Server sigue siendo la opción más adecuada.
No se trata, por lo tanto, de sustituir un motor por otro, sino de asignar cada procesamiento al que es capaz de ejecutarlo mejor, aprovechando los sistemas ya existentes.
Las cinco funcionalidades, vistas desde las dos perspectivas: quienes diseñan los pipelines y quienes utilizan sus resultados.
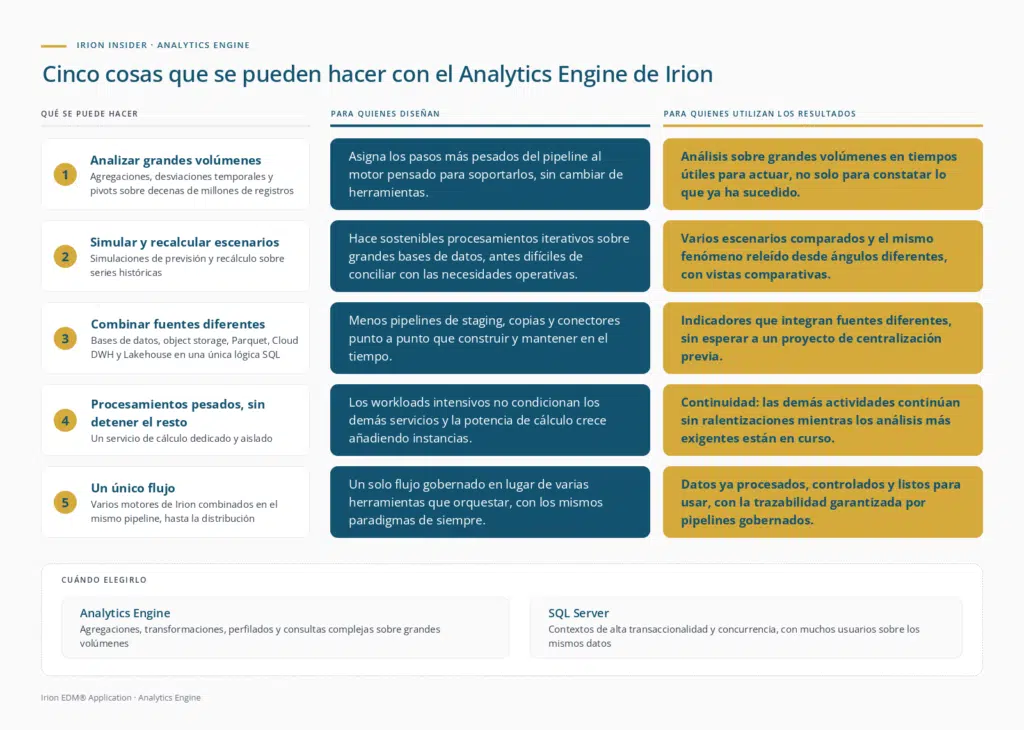
En síntesis
El Analytics Engine amplía lo que se puede hacer en Irion EDM: análisis sobre grandes volúmenes, simulaciones, procesamientos cross-source, workloads intensivos aislados del resto del sistema y flujos completos que combinan varios motores. Para quienes diseñan, es una herramienta más que elegir con criterio; para quienes utilizan los resultados, es la posibilidad de tener análisis más amplios y más oportunos, dentro de procesos gobernados.
Para quienes quieran entender lo que sucede bajo la superficie, el artículo Under the Hood Dentro del Analytics Engine: cómo Irion separa el cómputo del almacenamiento describe su arquitectura.
FAQ
El Analytics Engine está indicado para los procesamientos analíticos intensivos sobre grandes volúmenes y fuentes heterogéneas: agregaciones, desviaciones temporales, pivots, simulaciones sobre series históricas, transformaciones, perfilados y consultas complejas. En los contextos de alta transaccionalidad y concurrencia sigue siendo más adecuado el motor relacional basado en SQL Server.
No. El Analytics Engine opera como un motor SQL y se utiliza con los mismos paradigmas y herramientas de Irion EDM® Application, dentro de los mismos pipelines, sin un entorno de desarrollo separado.
Sí. En la misma ejecución, el Analytics Engine puede intercambiar resultados con los demás motores de procesamiento de Irion, entre ellos Query, Rule, Python, R, Masking, Profiler y Script, combinando procesamiento, controles de calidad y distribución de los datos en un único flujo.
El Analytics Engine lee directamente datos en object storage en la nube, archivos Parquet, Cloud Data Warehouses y entornos Lakehouse. Cuando la fuente lo admite, delega parte del procesamiento a la propia fuente, reduciendo staging y copias; algunos procesamientos cross-source pueden, no obstante, requerir transferir o materializar los datos.
No. Los procesamientos del Analytics Engine se ejecutan en un servicio dedicado y aislado, de modo que los workloads más intensivos no interfieran con los demás servicios de la aplicación.